library(ThSQCA)ThSQCA 入門 第2回: 4つのスイープと、範囲の決め方
ThSQCA
tutorial
アウトカム、1つの条件、複数の条件、その両方をスイープします。練習用データで4つのスイープをすべて実行し、擁護できる閾値の範囲の決め方を考えます。
第1回では、アウトカム閾値スイープを実行して、結果を読みました。ThSQCAには、スイープの関数が全部で4つあります。この回では、同じ練習用データで4つすべてを実行し、最後に、閾値の範囲の選び方についての、実践的な助言を述べます。
4つのスイープの一覧
| 問い | 関数 | 動かすもの | 固定するもの |
|---|---|---|---|
| アウトカムの目標水準が上がると、解はどう変わるか | otSweep() |
アウトカムの閾値 | すべての条件の閾値 |
| 1つの条件の「高い」の定義に、どれだけ敏感か | ctSweepS() |
1つの条件の閾値 | アウトカムと、ほかの条件 |
| 複数の条件の定義が、一緒に変わったらどうなるか | ctSweepM() |
複数の条件の閾値(格子状) | アウトカムの閾値 |
| 目標水準と、条件の定義の両方が変わったらどうなるか | dtSweep() |
アウトカムと条件 | なし |
準備: 第1回と同じ練習用データ
練習用データ(第1回と同じ)
make_demo_data <- function(n = 400, seed = 2026) {
  set.seed(seed)
  clip <- function(x) pmin(10, pmax(0, round(x)))
  QUA <- clip(rnorm(n, 6, 2))
  SER <- clip(rnorm(n, 6, 2))
  ENV <- clip(rnorm(n, 6, 2))
  core <- pmax(pmin(QUA, SER), pmin(QUA, ENV) - 1)
  LOY  <- clip(core + rnorm(n, 0, 0.7))
  data.frame(LOY, QUA, SER, ENV)
}

demo <- make_demo_data()データの背景を思い出してください。品質(QUA)とサービス(SER)がどちらも高いとき、または、それより少し弱く、品質と店舗環境(ENV)がどちらも高いときに、ロイヤルティ(LOY)が高くなります。
スイープ1: ctSweepS() で、1つの条件を動かす
「サービスが高い」の線をどこに引くか、迷っているとします。6で十分でしょうか。7でしょうか。9でしょうか。アウトカムを LOY >= 7 に固定し、ほかの条件を7に固定して、SER の閾値を5から9まで動かします。
res_cts <- ctSweepS(
  dat          = demo,
  outcome      = "LOY",
  conditions   = c("QUA", "SER", "ENV"),
  sweep_var    = "SER",
  sweep_range  = 5:9,
  thrY         = 7,
  thrX_default = 7
)

summary(res_cts)
CTS (single) Summary
====================
Analysis Parameters:
Outcome: LOY
Conditions: QUA, SER, ENV
Consistency cutoff: 0.8
Frequency cutoff: 1
Results by Threshold:
threshold expression inclS covS n_solutions
5 No solution NA NA 0
6 No solution NA NA 0
7 QUA*SER 0.894 0.656 1
8 QUA*SER 0.909 0.333 1
9 QUA*SER*~ENV 0.917 0.122 1新しい引数は、sweep_var(閾値を動かす条件)、thrY(固定するアウトカムの閾値)、thrX_default(ほかのすべての条件の、固定する閾値)です。
表を上から下へ読みます。「サービスが高い」を5または6と定義すると、解はありません。定義がゆるすぎて、「サービスを十分に受けた」顧客の集団が、もはや確実にはロイヤルではなくなるからです。7と8では、解は QUA*SER です。9では、解に3つ目の要素が加わって QUA*SER*~ENV になり、カバレッジは、7での0.656から、9での0.122へと、大きく下がります。いちばん厳しい定義の背後に、顧客が何人いるかを数えると、理由が分かります。
sum(demo$QUA >= 7 & demo$SER >= 9) # 品質とサービスの両方が高い顧客[1] 16sum(demo$QUA >= 7 & demo$SER >= 9 & demo$ENV < 7) # 解 QUA*SER*~ENV を満たす顧客[1] 12その水準で、品質とサービスの両方が高い顧客は、400人のうち16人です。そのうち、店舗環境が7未満で、解 QUA*SER*~ENV を満たす顧客は、12人だけです。そこでの結果は、ごく少数の事例に支えられています。これは役に立つ習慣です。解が格子の端にしか現れないときは、その背後にある事例の数を確かめてください。
スイープ2: ctSweepM() で、複数の条件を動かす
次に、3つの条件の閾値を、一度に動かします。QUA、SER、ENV のそれぞれを、6、7、8で試します。3 x 3 x 3 = 27通りの組み合わせです。アウトカムは LOY >= 7 のままです。
res_mcts <- ctSweepM(
  dat        = demo,
  outcome    = "LOY",
  conditions = c("QUA", "SER", "ENV"),
  sweep_list = list(QUA = 6:8, SER = 6:8, ENV = 6:8),
  thrY       = 7
)
出力は27行になります。読みやすくするために、解が出た組み合わせだけを表示します。
tab <- res_mcts$summary
tab[tab$n_solutions > 0, ]
combo_id threshold expression inclS covS
5 5 QUA=7, SER=7, ENV=6 QUA*SER 0.8939394 0.6555556
6 6 QUA=8, SER=7, ENV=6 QUA*SER 0.9189189 0.3777778
8 8 QUA=7, SER=8, ENV=6 QUA*SER 0.9090909 0.3333333
9 9 QUA=8, SER=8, ENV=6 QUA*SER 0.9047619 0.2111111
12 12 QUA=8, SER=6, ENV=7 QUA*SER*~ENV 0.8000000 0.3111111
14 14 QUA=7, SER=7, ENV=7 QUA*SER 0.8939394 0.6555556
15 15 QUA=8, SER=7, ENV=7 QUA*SER*~ENV 1.0000000 0.3000000
17 17 QUA=7, SER=8, ENV=7 QUA*SER 0.9090909 0.3333333
18 18 QUA=8, SER=8, ENV=7 QUA*SER*~ENV 1.0000000 0.1888889
21 21 QUA=8, SER=6, ENV=8 QUA*ENV 0.8888889 0.1777778
23 23 QUA=7, SER=7, ENV=8 QUA*SER 0.8939394 0.6555556
24 24 QUA=8, SER=7, ENV=8 QUA*SER + QUA*ENV 0.9200000 0.5111111
26 26 QUA=7, SER=8, ENV=8 QUA*SER 0.9090909 0.3333333
27 27 QUA=8, SER=8, ENV=8 QUA*SER*~ENV + QUA*~SER*ENV 0.9393939 0.3444444
n_solutions
5 1
6 1
8 1
9 1
12 1
14 1
15 1
17 1
18 1
21 1
23 1
24 1
26 1
27 1注目したいパターンは、次のとおりです。
- 27通りのうち、解があるのは14通りです。「品質が高い」を6と定義した組み合わせでは、解がまったくありません。
QUAが7で、SERが7または8のとき、ENVの閾値がどれであっても、解はQUA*SERです。これが安定した領域です。QUAが8のとき、解はENV(とSER)に左右されます。ENVが6なら、(SERが7または8のとき)QUA*SERです。ENVが7なら、QUA*SER*~ENVです。ENVが8なら、QUA*ENVだけのものから、QUA*SER + QUA*ENVのような2つの経路をもつ解まで、さまざまです。「品質が高い」を厳しく定義すると、店舗環境の定義が重要になり始めます。
格子を見ると、結論が頑健なところと、もろいところの両方が分かります。1回の分析では、これはできません。
スイープ3: dtSweep() で、アウトカムと条件を一緒に動かす
二重閾値スイープは、2つの考え方を組み合わせて、アウトカムの目標水準と条件の定義を、同時に動かします。ここでは、アウトカムの閾値を3つ(6、7、8)、条件の組み合わせを8つ(QUA、SER、ENV のそれぞれが6または7)にして、24のセルを作ります。
res_dts <- dtSweep(
  dat           = demo,
  outcome       = "LOY",
  conditions    = c("QUA", "SER", "ENV"),
  sweep_list_X  = list(QUA = 6:7, SER = 6:7, ENV = 6:7),
  sweep_range_Y = 6:8
)

res_dts$summary
combo_id thrY thrX expression inclS covS
1 1 6 QUA=6, SER=6, ENV=6 QUA*SER 0.8630137 0.7118644
2 1 7 QUA=6, SER=6, ENV=6 No solution NA NA
3 1 8 QUA=6, SER=6, ENV=6 No solution NA NA
4 2 6 QUA=7, SER=6, ENV=6 QUA*SER 0.9215686 0.5310734
5 2 7 QUA=7, SER=6, ENV=6 No solution NA NA
6 2 8 QUA=7, SER=6, ENV=6 No solution NA NA
7 3 6 QUA=6, SER=7, ENV=6 QUA*SER 0.8932039 0.5197740
8 3 7 QUA=6, SER=7, ENV=6 No solution NA NA
9 3 8 QUA=6, SER=7, ENV=6 No solution NA NA
10 4 6 QUA=7, SER=7, ENV=6 QUA*SER 0.9848485 0.3672316
11 4 7 QUA=7, SER=7, ENV=6 QUA*SER 0.8939394 0.6555556
12 4 8 QUA=7, SER=7, ENV=6 No solution NA NA
13 5 6 QUA=6, SER=6, ENV=7 QUA*SER 0.8630137 0.7118644
14 5 7 QUA=6, SER=6, ENV=7 No solution NA NA
15 5 8 QUA=6, SER=6, ENV=7 No solution NA NA
16 6 6 QUA=7, SER=6, ENV=7 QUA*SER + QUA*ENV 0.9076923 0.6666667
17 6 7 QUA=7, SER=6, ENV=7 No solution NA NA
18 6 8 QUA=7, SER=6, ENV=7 No solution NA NA
19 7 6 QUA=6, SER=7, ENV=7 QUA*SER 0.8932039 0.5197740
20 7 7 QUA=6, SER=7, ENV=7 No solution NA NA
21 7 8 QUA=6, SER=7, ENV=7 No solution NA NA
22 8 6 QUA=7, SER=7, ENV=7 QUA*SER + QUA*ENV 0.9259259 0.5649718
23 8 7 QUA=7, SER=7, ENV=7 QUA*SER 0.8939394 0.6555556
24 8 8 QUA=7, SER=7, ENV=7 No solution NA NA
n_solutions
1 1
2 0
3 0
4 1
5 0
6 0
7 1
8 0
9 0
10 1
11 1
12 0
13 1
14 0
15 0
16 1
17 0
18 0
19 1
20 0
21 0
22 1
23 1
24 0読み方です。LOY >= 6 では、8通りの条件の定義のすべてで解があり、たいていは QUA*SER で、ときには QUA*SER + QUA*ENV です。LOY >= 7 では、解が残るのは、QUA と SER がどちらも7の、2通りだけです。LOY >= 8 では、どれにも解がありません。このデータでは、目標水準を上げることが、変化のいちばん強い要因です。
図にすると、同じことがもっと早く分かります。次のチャンクは、24セルすべての解のカバレッジを、ヒートマップで描きます。1行が条件の定義ひとつ、1列がアウトカムの閾値ひとつで、「none」は解のないセルです。図の中の語は英語のままです。
s <- res_dts$summary
m <- tapply(s$covS, list(s$combo_id, s$thrY), function(x) x[1])
lab <- as.character(s$thrX[match(rownames(m), s$combo_id)])

op <- par(mar = c(4.5, 11, 3, 1))
image(x = seq_len(ncol(m)), y = seq_len(nrow(m)), z = t(m),
      col = colorRampPalette(c("#FFFFFF", "#233A9A"))(50), zlim = c(0, 1),
      xaxt = "n", yaxt = "n", xlab = "Outcome threshold (thrY)", ylab = "",
      main = "Solution coverage in the 24 cells")
axis(1, at = seq_len(ncol(m)), labels = colnames(m))
axis(2, at = seq_len(nrow(m)), labels = lab, las = 1, cex.axis = 0.8)
for (i in seq_len(nrow(m))) for (j in seq_len(ncol(m))) {
  if (is.na(m[i, j])) text(j, i, "none", col = "grey50", cex = 0.8)
  else text(j, i, sprintf("%.2f", m[i, j]), cex = 0.8)
}
box()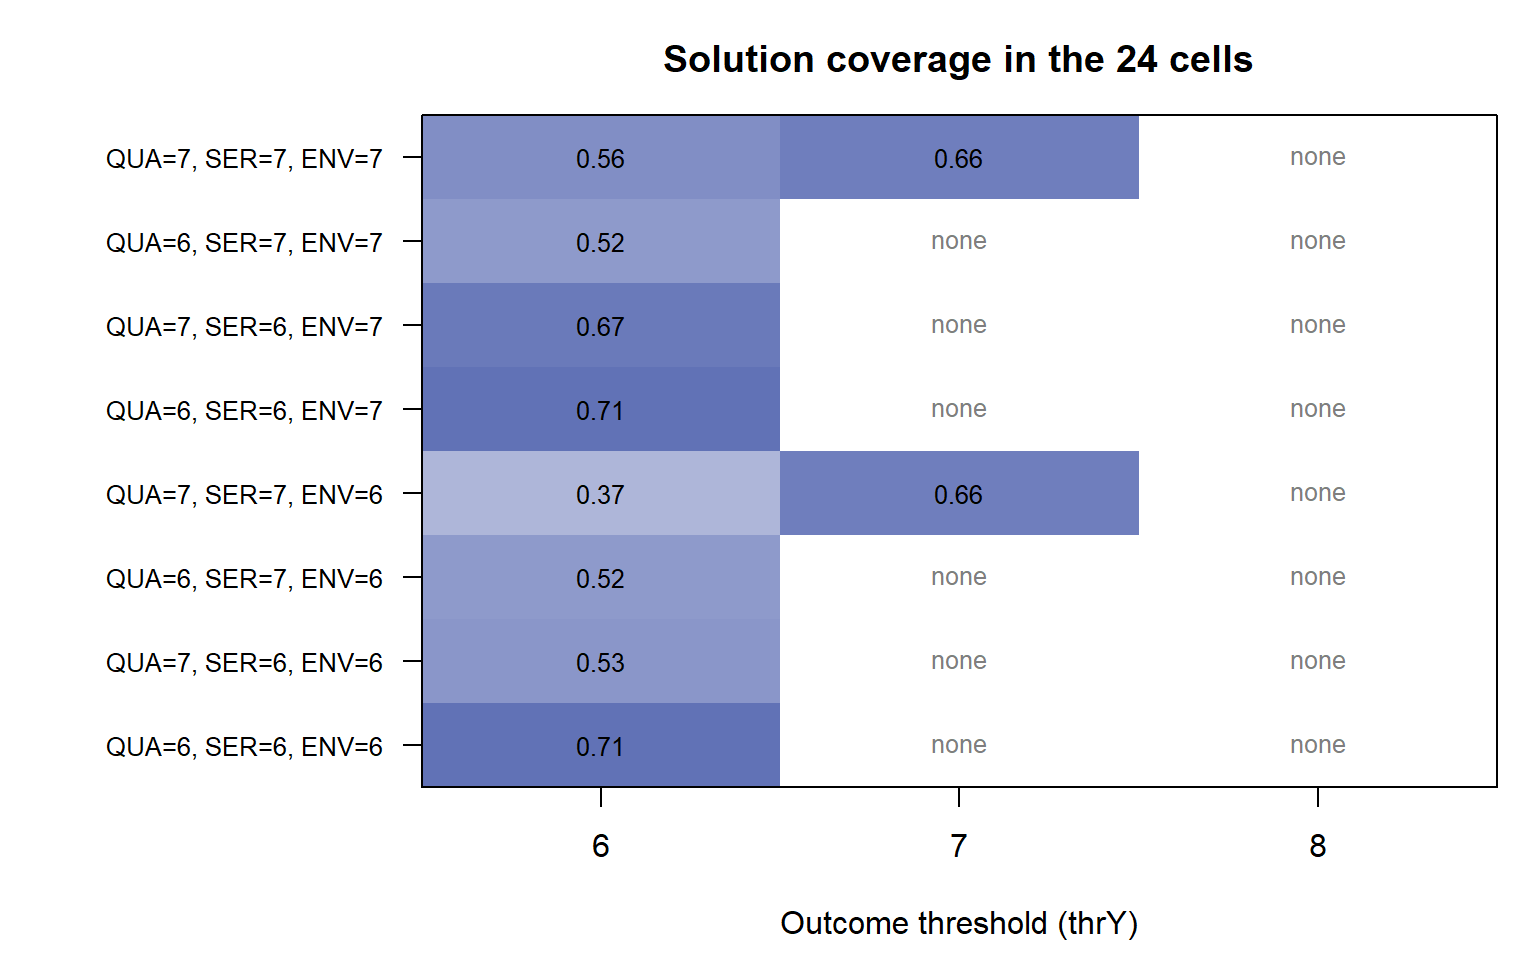
par(op)LOY >= 6 の列はすべての行で塗られ、LOY >= 7 の列は2行だけ、LOY >= 8 の列はどの行も塗られていません。
スイープの大きさ
すべてのセルが、1回分のQCA分析です。そのため、セルの数は、実行時間にも、結果の読みやすさにも関わります。
| 関数 | 分析の回数 | 例 |
|---|---|---|
otSweep() |
アウトカムの閾値ごとに1回 | 閾値5つ = 5回 |
ctSweepS() |
動かす条件の閾値ごとに1回 | 閾値5つ = 5回 |
ctSweepM() |
候補の数の積 | 3 x 3 x 3 = 27回 |
dtSweep() |
アウトカムの閾値 x 条件の格子 | 3 x (3 x 3 x 3) = 81回 |
擁護できる範囲を選ぶ
スイープは、簡単に実行できます。だからこそ、規律が必要です。たくさんの閾値を試して、都合のよいものだけを報告すれば、研究者の自由度を減らすどころか、増やしてしまいます。目安を挙げます。
- 結果を見る前に、範囲を決める。 尺度の意味、理論、実務上の目標(たとえば「許容できる」「良い」「とても良い」)に基づいて決めます。
- 基準点を含める。 通常の分析で使う閾値は、格子の中に入れておきます。読み手が比較できるようにするためです。
- 中立の領域を避ける。 0〜10の尺度では、中点のあたりの得点は、誰にとっても、はっきり「高い」とは言えません。そのため、範囲は、たいてい、それより上から始めます。
- 読める大きさに、格子を抑える。 変数ごとに、意味のある値を少し選ぶほうが、可能な値をすべて並べるより、よいです。
- 端の事例数を確かめる。 格子の端のセルは、ごく少数の事例に支えられていることが、よくあります。
- 格子全体を報告する。 ストーリーに合うセルだけでなく、安定した領域も、不安定な領域も、示します。
次回
第3回では、3種類の解(複雑解、倹約解、中間解)と、1つのセルに最小解が複数あるときの対処を扱います。
使ったソフトウェア: R 4.6.1、QCA 3.25.5、ThSQCA 2.0.9