install.packages(c("QCA", "ThSQCA"))ThSQCA 入門 第1回: はじめての閾値スイープ
ThSQCA
tutorial
Rで閾値スイープQCAを、順を追って学びます。データは要りません。小さな練習用データを作り、ThSQCAで最初のスイープを実行します。
これは、閾値スイープ質的比較分析(QCA)のRパッケージ ThSQCA を学ぶ、入門シリーズの第1回です。QCAを事前に知っている必要はありません。この回の終わりには、閾値スイープを自分で実行して、結果を読めるようになります。
知っておくべき、ひとつの考え方
QCAは、あるアウトカムにとって「十分」な条件の組み合わせを探します。顧客ロイヤルティを例にしましょう。「品質が高く、かつサービスが高い」という組み合わせは、それをもつ顧客のほぼ全員が、ロイヤルティも高いなら、ロイヤルティが高いことに十分です。
これを行うために、QCAはまず、「高い」とは誰のことかを決めなければなりません。0〜10点の調査の得点なら、閾値を選びます。得点が閾値以上なら、その変数で「高い」とします。このシリーズでは、得点を閾値で「高い」と「高くない」の2つに分ける、二値(crisp-set)QCA を使います。
ここに落とし穴があります。閾値7も閾値8も、どちらも妥当ですが、答えが変わることがあります。通常のQCA分析は、閾値を1つ選んで、答えを1つ報告します。ThSQCAは、同じ分析を、閾値の範囲全体で繰り返し、すべての答えを1つの表にまとめます。答えが保たれるところと、変わるところが、見えるようになります。
ThSQCAは、QCA パッケージの代わりではありません。閾値ごとに、QCAの truthTable() と minimize() を、毎回同じ設定で呼び出して、結果を集めます。
ステップ1: パッケージをインストールする
1回だけ実行します。(すでにインストールしてあれば、省略してください。)
そのあと、新しいRのセッションごとに、ThSQCAを読み込みます。
library(ThSQCA)ステップ2: 小さな練習用データを作る
再現できるように、400人の顧客をシミュレーションで作ります。各顧客は、0〜10点の4つの得点をもちます。ロイヤルティ(LOY)と、品質(QUA)、サービス(SER)、店舗環境(ENV)の評価です。この模擬の世界では、品質とサービスがどちらも高いとき、または、(それより少し弱く)品質と環境がどちらも高いときに、ロイヤルティが高くなります。良い分析なら、これを見つけ出すはずです。
make_demo_data <- function(n = 400, seed = 2026) {
  set.seed(seed)
  clip <- function(x) pmin(10, pmax(0, round(x)))
  QUA <- clip(rnorm(n, 6, 2))
  SER <- clip(rnorm(n, 6, 2))
  ENV <- clip(rnorm(n, 6, 2))
  core <- pmax(pmin(QUA, SER), pmin(QUA, ENV) - 1)
  LOY  <- clip(core + rnorm(n, 0, 0.7))
  data.frame(LOY, QUA, SER, ENV)
}

demo <- make_demo_data()
head(demo)
LOY QUA SER ENV
1 7 7 9 3
2 5 4 7 5
3 4 6 4 4
4 6 6 6 4
5 5 5 4 7
6 0 1 2 51行が、1人の顧客です。上の関数は、理解しなくても構いません。練習用データを作るためだけのものです。自分のデータでは、このような列をもつデータフレームに、ファイルを読み込むだけです。
ステップ3: スイープを実行する
知りたいのは、「高いロイヤルティ」の基準を上げると、答えがどう変わるか、です。そこで、3つの条件の閾値は7に固定し、アウトカムの閾値を5から8まで動かします。これをアウトカム閾値スイープと呼び、関数は otSweep() です。
res <- otSweep(
  dat         = demo,
  outcome     = "LOY",
  conditions  = c("QUA", "SER", "ENV"),
  sweep_range = 5:8,
  thrX        = c(QUA = 7, SER = 7, ENV = 7)
)
各行の意味は、次のとおりです。
| 引数 | 意味 |
|---|---|
dat |
分析するデータフレーム |
outcome |
アウトカムの列 |
conditions |
条件の列 |
sweep_range |
試すアウトカムの閾値。ここでは5、6、7、8 |
thrX |
各条件の固定した閾値。「高い」は7以上 |
ここに書いていない設定が2つあります。既定値があるためです。組み合わせが十分と認められる最低の一貫性(incl.cut、既定は0.8)と、組み合わせごとの最低の事例数(n.cut、既定は1)です。
ステップ4: 結果を読む
summary(res)OTS Summary
===========
Analysis Parameters:
Outcome: LOY
Conditions: QUA, SER, ENV
Consistency cutoff: 0.8
Frequency cutoff: 1
Results by Threshold:
thrY expression inclS covS n_solutions
5 QUA*SER + QUA*ENV 0.981 0.403 1
6 QUA*SER + QUA*ENV 0.926 0.565 1
7 QUA*SER 0.894 0.656 1
8 No solution NA NA 0表は、アウトカムの閾値ごとに1行です。列は、次のとおりです。
thrY: その行で使ったアウトカムの閾値。1行目では、「高いロイヤルティ」はLOY >= 5を意味します。expression: 見つかった十分な組み合わせ。*はAND、+はOR、~はNOTです。inclS: 解の一貫性。解がカバーする事例が、どれだけ確実に、アウトカムの集合に入っているか。高いほどよく、1が完全です。covS: 解のカバレッジ。アウトカムをもつ事例のうち、解が説明する割合です。n_solutions: 見つかった、等価な最小解の数(ここでは1)。
では、expression の列を、上から下へ読みましょう。
LOY >= 5とLOY >= 6では、2つの組み合わせが十分です。QUA*SER(品質が高く、サービスが高い)と、QUA*ENV(品質が高く、店舗環境が高い)です。LOY >= 7では、QUA*SERだけが残ります。LOY >= 8では、結果は No solution(解なし)です。この水準では、3つの条件のどの組み合わせも、必要な一貫性に届きませんでした。
これは、シミュレーションに入れておいたとおりの結果で、スイープが役立つ理由も示しています。LOY >= 6 だけを分析していたら、経路が2つあると報告したでしょう。LOY >= 7 だけなら、1つと報告したでしょう。スイープは、答えが、目標がどれだけ高いかに左右されること、そして、どこで通用しなくなるかを、見せてくれます。
「No solution」についての注意です。これは技術的な結果で、高いロイヤルティへの経路が存在しない、という意味ではありません。このデータとこの設定では、QCAが、一貫性の条件を満たす最小解を作れなかった、という意味です。
ステップ5: 結果を図で見る
表は正確ですが、図にすると、傾向がひと目で分かります。要約の表は普通のデータフレーム(res$summary)なので、基本のRで図にできます。次のチャンクは、アウトカムの閾値ごとに、解のカバレッジと解の一貫性を描きます。図の中の語は英語のままです。
tab <- res$summary

plot(tab$thrY, tab$covS, type = "b", pch = 19, lwd = 2, col = "#233A9A",
     xlim = c(4.8, 8.2), ylim = c(0, 1), xaxt = "n",
     xlab = "Outcome threshold (thrY)", ylab = "Score",
     main = "Coverage and consistency by threshold")
axis(1, at = tab$thrY)
lines(tab$thrY, tab$inclS, type = "b", pch = 17, lwd = 2, col = "#F28018")
abline(v = 8, lty = 3, col = "grey60")
text(7.9, 0.3, "No solution\nat thrY = 8", adj = 1, col = "grey40")
legend("bottomleft", legend = c("Coverage (covS)", "Consistency (inclS)"),
       col = c("#233A9A", "#F28018"), pch = c(19, 17), lwd = 2, bty = "n")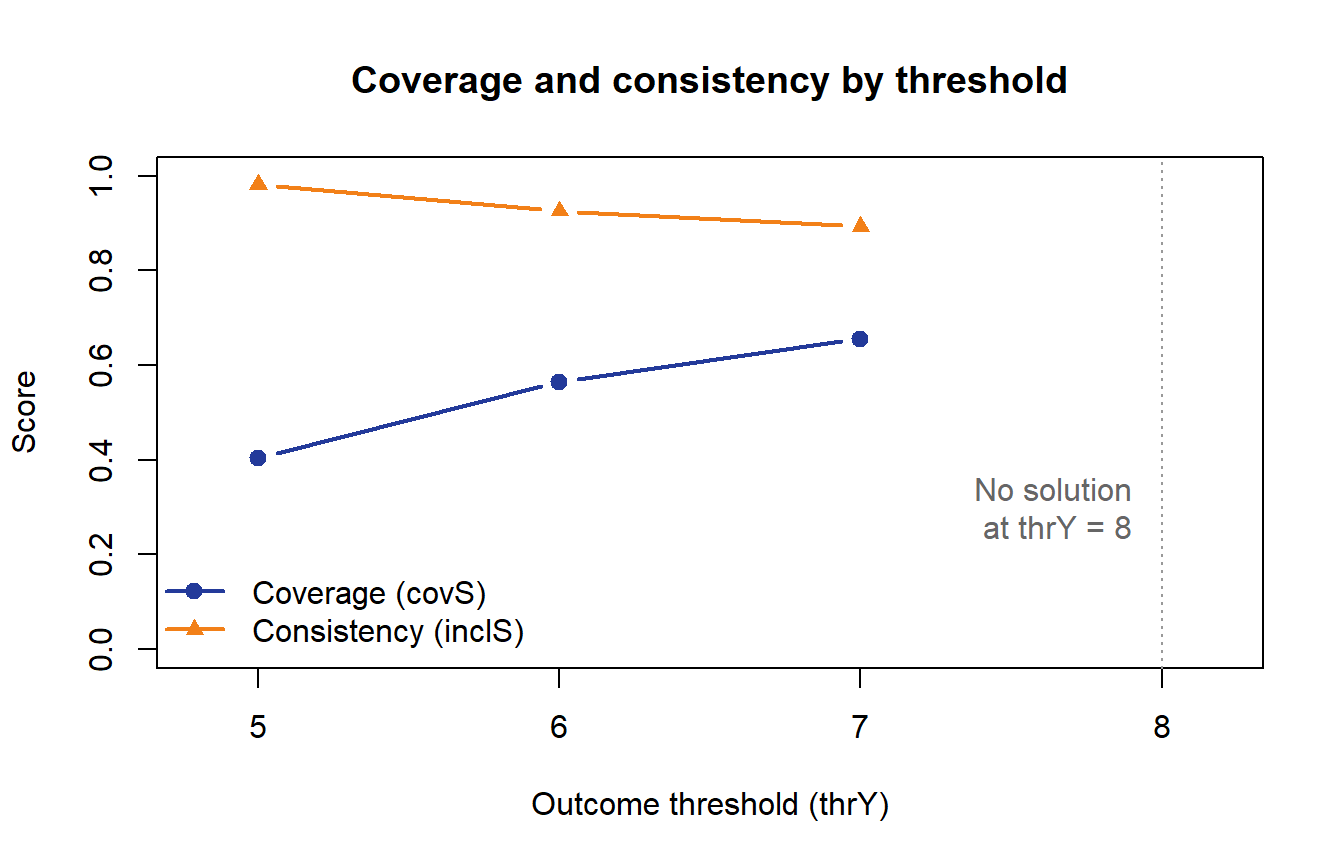
目標が高くなるほど、カバレッジは上がり(解が、高ロイヤルティの顧客のより大きな割合を説明します)、一貫性はゆっくり下がります。thrY = 8 では、プロットする解がないので、線がそこで止まります。
次回
次回は、4種類のスイープ(アウトカム、1つの条件、複数の条件、その両方)を、もう少し詳しく見ます。あわせて、擁護できる閾値の範囲の決め方を扱います。
パッケージの完全なチュートリアルは、ThSQCAのドキュメント(英語)にあります。手法そのものは、Toyoda (2026), Quality & Quantity で説明しています。
使ったソフトウェア: R 4.6.1、QCA 3.25.5、ThSQCA 2.0.9