このブログの手順記事には、同じ手順を試せるアプリ(ブラウザで動くツール)があります。3つの役割は、次のとおりです。
記事 : 考え方と手順を説明します。計算は、Rのコードで示します。アプリ(Scale Maker ) : データ(CSV)を読み込むと、記事と同じ計算の結果が、画面で見られます。Rを使わなくても、手順の流れと、数値の意味を学べます。Rスクリプト : アプリは、画面での設定どおりの結果を再現するRスクリプトを出せます。Rで実行して、アプリの数値と一致することを確かめられます。研究では、このスクリプトを、分析の記録としても使えます。
Rを使う方は、記事のコードから読んでください。アプリで学ぶ方は、まずアプリの数値を見ながら記事を読み、慣れたらRスクリプトで再現してください。
この記事の問い
マーケティングや経営学の研究では、「ブランド信頼」「知覚品質」「顧客満足」「価格感度」のように、1つの質問だけでは測りにくい概念を扱います。こうした概念は構成概念 と呼ばれ、複数の質問項目で測ります。
たとえば「ブランド信頼」を、次の3項目で測るとします。
Q1: このブランドは誠実である
Q2: このブランドは約束を守ると思う
Q3: このブランドは安心して利用できる
知りたいのは、Q1、Q2、Q3それぞれの効果ではありません。3つを合わせた「ブランド信頼」が、購買意向などとどう関係するかです。さらに、そうした概念を、回帰分析、ロジスティック回帰、QCA、クラスター分析、決定木など、あとの分析で使いたいことも多くあります。
なお、共分散構造分析(SEM)は素晴らしい手法ですが、最初から使う必要はありません(使う場合には、SEMの特徴をしっかり理解して使わないと、かえって危険です)。大切なのは、「どの手法が高度か」ではなく、研究上の構成概念をどう測り、研究質問にいちばん合う形でどう分析するか です。
この記事では、MBAの研究や実証研究で使いやすい手順を、Rの例で示します。例題のデータは、乱数で作ったものです(本物の調査データではありません)。
この記事の範囲
理論的に想定した構成概念を、複数項目で測る場合 を扱います。データから構成概念を探す探索的な研究を、否定するものではありません。
ブランド信頼のように、「背後に1つの概念があり、それが複数の項目への回答を共通に動かしている 」と考えられる測定を扱います。ブランド信頼が高い人は、Q1もQ2もQ3も高く答える、という関係です。そのため、項目どうしが相関することが前提になります(このような測定を、反映的な測定と呼びます)。
一方、購入頻度・購入金額・利用年数を組み合わせて、「顧客の行動指標」を作るような場合は違います。頻度が高い人が、金額も高いとは限りません。項目が互いに強く相関するとは限らないので、ここで示す因子分析とαの手順は、そのまま当てはまりません。「どんな指標でも、αを高くして平均すればよい」わけではないのです。
全体の流れ
理論と先行研究から、構成概念を定義する
構成概念ごとに、複数の質問項目を用意する
探索的因子分析(EFA)で、想定した項目のまとまりと、データとの整合性を探索的に検討する
逆転項目の向きをそろえる
内的一貫性(Cronbachのα)を確認する
項目の平均で、下位尺度を作る
下位尺度を、回帰分析やQCAに使う
順番に説明します。
アプリ(Scale Maker )の「例題3」が、この記事と同じデータです。アプリの手順2〜7が、この記事の手順3〜6にあたります。回帰分析とQCAは、Rで行います。アプリの計算は、Rの標準の promax と同じです。psych のバージョンによっては、因子負荷量の小数第3位が、少しずれることがあります。
手順1: 理論で構成概念を定義する(因子分析の前にやること)
ここがいちばん大切です。因子分析の前に、「何を測りたいのか」を研究者自身が決めておく必要があります。「ブランド信頼」や「知覚品質」は、統計ソフトが自動的に見つけてくれる概念ではありません。
避けたいのは、次の進め方です。
「とりあえず20問聞いて、因子分析をして、出てきた因子に名前をつけよう」
特に初学者が陥りやすい誤解です。望ましい順序は、次のとおりです。
先行研究や理論から「ブランド信頼とは何か」を定義し、その概念を観測するために必要な質問項目を考えます。上のQ1〜Q3を用意した時点で、研究者は調査を始める前から、「この3項目は、ブランド信頼という1つの構成概念を測っているはずだ」という理論的な想定を持っています。そのうえで因子分析を行い、実際の回答データでも、その3項目が同じ方向にまとまっているか を確かめます。
\[
\text{理論} \rightarrow \text{構成概念の定義} \rightarrow \text{測定項目の設計} \rightarrow \text{データ収集} \rightarrow \text{因子分析による整合性の検討}
\]
因子分析から理論を作るのではなく、理論的に想定した測定構造と、実際のデータとの整合性を、探索的に検討します。そのためにも、事前の先行研究や理論のリサーチは、非常に重要です。
因子分析は「項目を自動で分類する機械」ではない
20項目を因子分析して、4つの因子が得られたとします。それだけでは、「人間の態度は4つの構成概念から成り立っている」とは言えません。因子分析が示すのは、「このサンプルでは、この項目群の相関構造を、4つほどの共通因子で整理すると、比較的うまく説明できる」という統計的な事実だけです。
その4因子が、ブランド信頼なのか、品質評価なのか、ブランド愛着なのかは、統計の結果からは決まりません。先行研究、質問項目の内容、概念の定義、研究目的を踏まえて、解釈する必要があります。出てきた因子に、もっともらしい名前をつける方法は避けてください。
統計的なまとまりと、理論上の妥当性は別のもの
「品質が高い」「デザインが良い」「価格が手頃」「有名ブランドである」の4項目が、統計的に1つの因子にまとまったとします。それだけで、その因子を「ブランド価値」と呼んでよいとは限りません。統計的にまとまる理由には、次のような可能性があります。
本当に同じ構成概念を測っている
回答者が全体に高く評価する傾向がある
ハロー効果がある
質問文の表現が似ている
同じ尺度形式による、方法の影響(method effect)がある
因子負荷量が高いことは、理論上も同じ概念であることの証明にはなりません。
手順2: 構成概念ごとに、複数の項目を用意する
原則として、1つの構成概念に複数の項目を用意します。このとき、同じ文章を言い換えただけの項目を並べないでください。意味が同じ項目を並べると、Cronbachのαは高くなりやすいのですが、それは、構成概念の必要な側面を十分にカバーしていることを意味しません。項目は、構成概念の異なる側面を、適切に表すものであることが望ましいです。
たとえば、ブランド信頼を測る項目として、次の2通りを比べてみます。
言い換えを並べた例
このブランドは信頼できる
このブランドは頼りになる
このブランドは信用できる
3つとも、ほぼ同じことを聞いています。回答は似通うので、αは高くなります。しかし、αを高くするために内容を重複させると、ブランド信頼の必要な側面を十分にカバーしているかが、分からなくなります。カバーしているかどうかは、別に検討する必要があります。なお、測定したい概念が狭い場合は、意味の近い項目が適切なこともあります。表現の違いによる誤差を、平均化する役割もあります。
異なる側面を表す例
このブランドは約束を守ると思う(約束を果たす、という側面)
このブランドは誠実である(相手のことを考える、という側面)
このブランドは安心して利用できる(使うときの安心感、という側面)
3つとも「ブランド信頼」の一部ですが、見ている側面が違います。ブランド信頼という概念を、より幅広く捉えられます。ただし、側面を変えすぎると、項目どうしの相関が下がり、1つの因子にまとまらなくなります。概念の定義に照らして、「同じ概念の別の側面」と言える範囲で選びます。
選択肢のラベルの付け方には、主に2つの方法があります。
7つすべてに、言葉のラベルを付ける : 各選択肢の意味が明確になります。一方で、「とても」「非常に」「かなり」のような言葉は、受け取る人によって強さの感じ方が違います。両端にだけラベルを付け、間は数字だけにする : 言葉の強さの感じ方の違いを、避けやすくなります。
あてはまらない 1 - 2 - 3 - 4 - 5 - 6 - 7 あてはまるどちらを使うかは、研究の目的と、使う既存尺度の形式に合わせて決めます。注意したいのは、どちらの形でも、得点を等間隔の数値として扱うことは、分析者の前提(簡略化)である 点です。ラベルの付け方で、等間隔性が保証されるわけではありません。この記事では、この前提のもとで、回答を数値として扱います。
先行研究で十分に使われている尺度があるなら、一から項目を作るよりも、既存尺度を使うほうがよいことが多くあります。妥当性が検討されていて、他の研究と比べやすいからです。ただし、「既存研究で3項目だから、そのまま使えばよい」という意味ではありません。産業、文化、回答者、調査目的が違えば、同じ因子構造が再現されないこともあります。既存尺度でも、今回のデータで構造を確かめる意味があります。
例題データ
ここからは、Rで手順を追います。9項目を、7件法で測ったとします。理論的な想定は、次の3つです。
ブランド信頼
Q1
このブランドは誠実である
Q2
このブランドは約束を守ると思う
Q3
このブランドは安心して利用できる
知覚品質
Q4
このブランドの商品は品質が高い
Q5
このブランドの商品は性能が優れている
Q6(逆転項目)
このブランドの商品は品質にばらつきがある
価格感度
Q7
少しの価格差でも気になる
Q8
値引きがあると買いたくなる
Q9
同じような商品なら、安い方を選ぶ
質問文は、例です(データは乱数で作ったもので、質問文に対応する調査があるわけではありません)。
結果の変数 Y は、購買意向(7件法の1項目)とします。
この記事では、7件法の回答を数値として扱い、ピアソンの相関と、線形の回帰分析を使います。実務では、よく使われる簡略化です。回答の分布が強く偏る場合などは、順序尺度として扱う方法も検討できます。たとえば、因子分析では、ポリコリック相関を使う方法(fa(..., cor = "poly"))があります。購買意向を1項目で測っている場合は、線形回帰のほかに、順序ロジスティック回帰も選べます。
次のコードで、例題のデータを作ります(乱数のシードを固定してあるので、同じデータになります)。
set.seed (2026 )<- 300 <- matrix (c (1.0 , 0.5 , - 0.2 ,0.5 , 1.0 , - 0.1 ,- 0.2 ,- 0.1 , 1.0 ), 3 , 3 , byrow = TRUE ) # 3つの概念の相関 <- matrix (rnorm (n * 3 ), n) %*% chol (Phi)<- c (.80 ,.75 ,.70 , .78 ,.72 ,.68 , .75 ,.70 ,.65 ) # 各項目の負荷量(理想の値) <- rep (1 : 3 , each = 3 )<- function (z) as.integer (cut (z, c (- Inf ,- 1.6 ,- 1.0 ,- 0.4 ,0.4 ,1.0 ,1.6 ,Inf ))) # 7件法にする <- sapply (1 : 9 , function (j) to7 (lam[j] * Fm[, fac[j]] + sqrt (1 - lam[j]^ 2 ) * rnorm (n)))6 ] <- 8 L - X[, 6 ] # Q6は逆転項目として記録する colnames (X) <- paste0 ("Q" , 1 : 9 )<- c (.45 , .30 , - .20 ) # 3つの概念から購買意向への効果 <- drop (t (b) %*% Phi %*% b) # 信号部分の分散(概念どうしの相関を含む) <- to7 (drop (Fm %*% b) + sqrt (1 - v) * rnorm (n)) # 全体の分散が1になるように、誤差を足す <- data.frame (X, Y = Y)head (dat)
  Q1 Q2 Q3 Q4 Q5 Q6 Q7 Q8 Q9 Y
1  5  5  3  3  3  3  4  4  6 6
2  2  4  2  3  3  5  5  4  5 3
3  4  4  3  3  4  5  5  6  3 4
4  5  4  4  4  5  1  5  4  4 3
5  4  4  4  4  2  7  3  4  4 4
6  2  1  1  2  2  6  4  5  5 1
手順3: 探索的因子分析で、想定した項目のまとまりを検討する
項目を用意したら、それらがどうまとまっているかを、探索的因子分析(EFA)で検討します。ここでEFAに期待する役割は、「何も分からない状態から、構成概念を発明すること」ではありません。理論的に想定した項目構造と、実際のデータが整合しているかを、探索的に検討すること です。EFAは、「どの項目がどの因子を測るか」を事前にモデルとして指定して検証する方法(確証的因子分析、CFA)とは違います。EFAの結果は、想定との整合性を見る材料であり、測定構造が検証されたという意味ではありません。
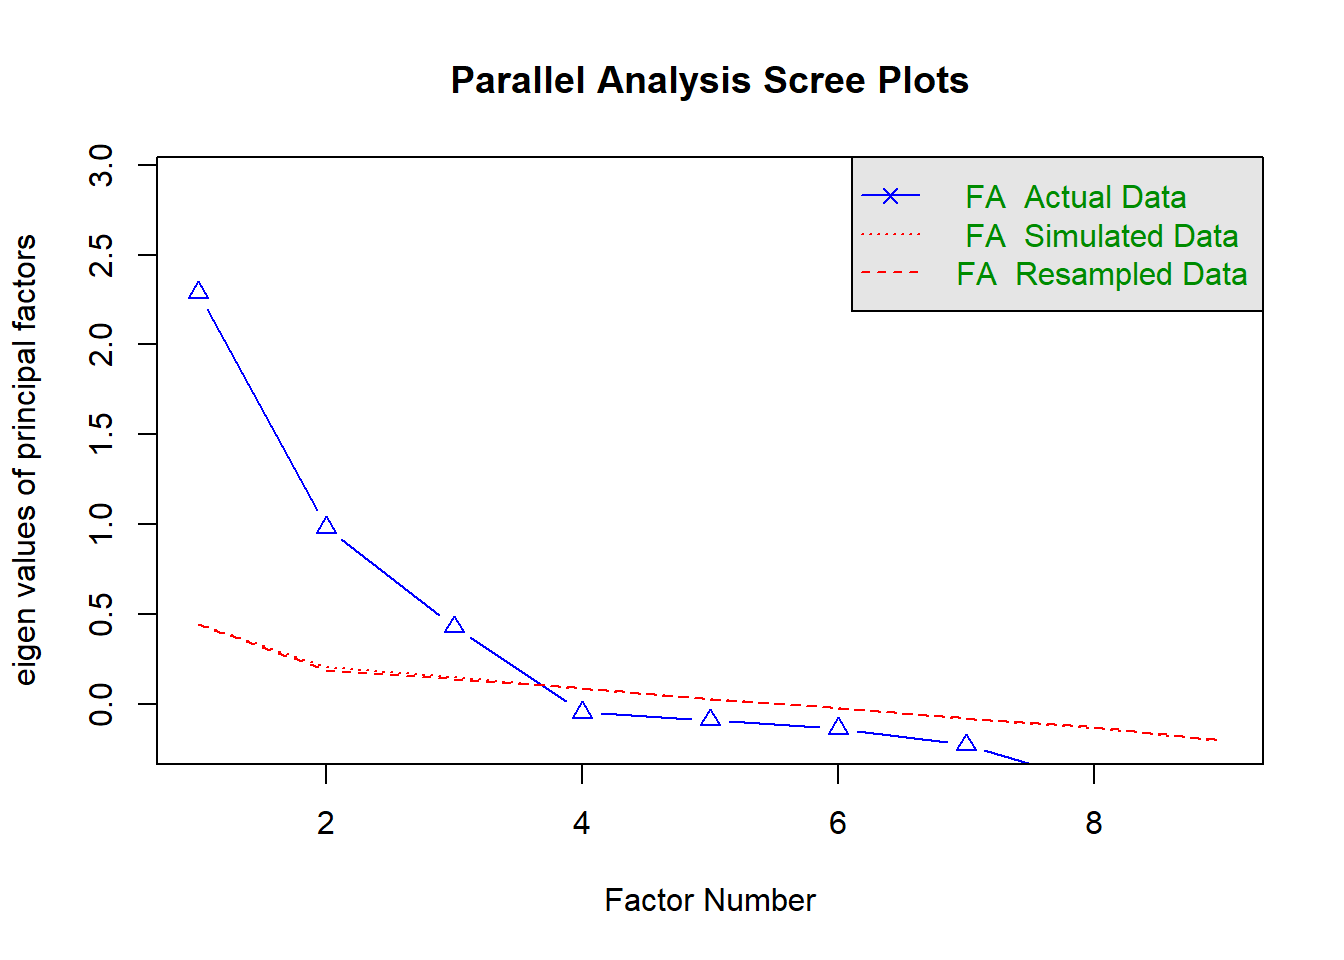
まず、因子数の目安として、相関行列の固有値と、平行分析を見ます。固有値1以上の数は、あくまで目安です。平行分析は、実データの固有値を、乱数のデータから得た固有値と比べて、因子数の手がかりにする方法です。理論上の想定とあわせて、因子数を決めます。そのうえで、主因子法・プロマックス回転で、3因子を求めます。
library (psych)<- paste0 ("Q" , 1 : 9 )round (eigen (cor (dat[, items]))$ values, 3 )
[1] 2.918 1.921 1.107 0.640 0.584 0.528 0.490 0.462 0.350
set.seed (2026 )fa.parallel (dat[, items], fa = "fa" , fm = "pa" ) # 平行分析(図が出ます)
Parallel analysis suggests that the number of factors = 3 and the number of components = NA
<- fa (dat[, items], nfactors = 3 , fm = "pa" , rotate = "Promax" ,min.err = 1e-8 , max.iter = 1000 ) # 反復計算の収束条件を、厳しくしています
Loading required namespace: GPArotation
print (fa3$ loadings, cutoff = 0.3 )
Loadings:
   PA1    PA3    PA2
Q1         0.731
Q2         0.724
Q3         0.582
Q4  0.769
Q5  0.775
Q6 -0.632
Q7                0.695
Q8                0.674
Q9                0.639

                PA1   PA3   PA2
SS loadings    1.62 1.430 1.350
Proportion Var 0.18 0.159 0.150
Cumulative Var 0.18 0.339 0.489
     PA1   PA3   PA2
PA1 1.00  0.54  0.01
PA3 0.54  1.00 -0.20
PA2 0.01 -0.20  1.00
この記事では、結果を再現しやすいように、rotate = "Promax"(先頭が大文字)を使っています。小文字の "promax" でも誤りではありませんが、計算の途中の正規化が異なるため、値が少し変わります。
min.err = 1e-8, max.iter = 1000 は、主因子法の反復計算を、厳しい条件で収束させる指定です。初期設定の条件は緩いため、因子の抽出の結果が、小数第3位あたりで少しずれることがあります。この記事では、結果をそろえるために、厳しい条件を使っています。
なお、psych のバージョンによって、プロマックス回転の計算が少し異なり、因子負荷量の小数第3位が変わることがあります(psych 2.4.1 と 2.6.5 で、最大0.003の差を確認しました)。因子の抽出(主因子法)の結果は、同じです。解釈は変わりません。
見る場所は、次のとおりです。
因子数 : 固有値(1以上の数)と、平行分析の図(実データの固有値が、乱数データの固有値を上回る数)を見て、理論上の想定の3因子と整合しているかを確かめます。項目のまとまり : Q1〜Q3、Q4〜Q6、Q7〜Q9が、想定どおり同じ因子に載っているか。(PA1 などの記号は、並び順を表すだけです。因子の中身は、載っている項目で読みます。)Q6の負荷量が負になっている点 : 同じ因子の中で、Q4・Q5と符号が逆です。Q6が逆転項目である可能性を示す手がかりです。ただし、符号は目安です(因子全体の符号は、向きを反転できます)。逆転項目かどうかは、質問文の意味で決めます。複数の因子に大きく載る項目(cross-loading)がないか 。
たとえば、Q3だけが知覚品質の因子に強く載った場合は、削除する前に、次のことを検討します。
Q3の表現は適切だったか
ブランド信頼と知覚品質が、概念的に近すぎないか
翻訳や言い回しに、問題がないか
回答者が、想定とは違う意味に受け取っていないか
EFAの結果は、「採用・削除の判定」ではなく、理論的に想定した測定モデルと、実際の回答行動とのズレを理解する材料 として使います。因子負荷量が少し低いという理由だけで、内容上重要な項目を機械的に削除すると、かえって内容的妥当性が損なわれることがあります。
手順4: 逆転項目の向きをそろえる
Q6は逆転項目です。実務では、分析の前に、質問文の意味から逆転項目を決めて、向きをそろえておくほうが分かりやすいでしょう。この記事では、負の負荷量が手がかりになることを見せるために、先にEFAを行いました。尺度の最小値と最大値(ここでは1と7)を使い、(最小値 + 最大値) − 元の値、つまり 8 - Q6 で向きをそろえます。1〜7なら 8 - Q6、1〜5なら 6 - Q6 です。最小値が1でない尺度(たとえば0〜10)でも、同じ式で逆転できます。最小値と最大値は、データの最小値・最大値ではなく、調査票の尺度の端(7件法なら1と7)を使ってください。逆転項目かどうかは、質問文の意味(理論)で決めます。
手順5: 内的一貫性(Cronbachのα)を確認する
因子構造を検討したら、項目群ごとに内的一貫性を確認します。代表的な指標がCronbachのαです。たとえば \(\alpha = .84\) なら、その項目群には、比較的高い内的一貫性があると言えます。
<- alpha (dat[, c ("Q1" , "Q2" , "Q3" )], check.keys = FALSE )<- alpha (dat[, c ("Q4" , "Q5" , "Q6r" )], check.keys = FALSE )<- alpha (dat[, c ("Q7" , "Q8" , "Q9" )], check.keys = FALSE )round (c (trust = a_trust$ total$ raw_alpha,quality = a_quality$ total$ raw_alpha,price = a_price$ total$ raw_alpha), 3 )
  trust quality   price
  0.731   0.774   0.705
注意点が2つあります。
αが高くても、1因子構造が証明されたわけではありません。 αは内的一貫性の指標であって、因子構造を検証する指標ではありません。また、αだけで、信頼性全般や妥当性を判断することはできません。 順序は、「因子分析で構造を検討する → その項目群の内的一貫性を確認する」です。αは、項目数が多いほど高くなりやすい指標です。必要に応じて、McDonaldのωを併用してもかまいません。
手順6: 下位尺度を作る
構造を検討し、内的一貫性を確認したら、構成概念ごとに下位尺度を作ります。通常は、項目の単純平均を基本とします。
\[
\text{Trust} = \frac{Q_1 + Q_2 + Q_3}{3}, \qquad
\text{Quality} = \frac{Q_4 + Q_5 + Q_{6r}}{3}
\]
$ Trust <- rowMeans (dat[, c ("Q1" , "Q2" , "Q3" )])$ Quality <- rowMeans (dat[, c ("Q4" , "Q5" , "Q6r" )])$ Price <- rowMeans (dat[, c ("Q7" , "Q8" , "Q9" )])round (cor (dat[, c ("Trust" , "Quality" , "Price" )]), 2 )
        Trust Quality Price
Trust    1.00    0.43 -0.14
Quality  0.43    1.00  0.01
Price   -0.14    0.01  1.00
単純平均で作った尺度にも、測定誤差は残ります。その尺度を使う通常の回帰分析は、測定誤差を明示的にモデル化していません。そのため、得られた係数は、潜在的な構成概念どうしの関係そのものとは、同じとは限りません。信頼性が低いと、この影響は大きくなりえます。特に重回帰では、測定誤差の影響は説明変数どうしの相関にも左右されるため、係数への影響を、信頼性だけから判断することはできません。
単純平均には、次の利点があります。
算出方法が明確で、再現性が高い
サンプルへの依存が、比較的小さい
元の質問尺度の単位が保たれ、解釈しやすい
回帰分析にも、QCAにも使える
因子得点は使わないのか
因子得点を使うこと自体が、誤りというわけではありません。ただし、因子得点には、重みがサンプルに依存する、推定方法によって値が変わる、得点そのものの意味が分かりにくい、別のサンプルでは同じ尺度にならない可能性がある、という問題があります。特別な理由がなければ、MBAレベルの研究では、信頼性を確かめた単純平均の尺度を基本にする方針は、十分に合理的です。
確証的因子分析(CFA)はどこで使うのか
MBAの探索的な研究では、項目の内容、EFAの結果、内的一貫性を踏まえて、単純平均の尺度を作る進め方は、実用的です。ただし、それだけで、測定の妥当性が十分に確立したとは言えません。
どこまで検証するかは、既存尺度の検証の実績、今回の変更の程度、研究で求める主張の強さで決まります。測定構造を明示的に検証したいときや、尺度を新しく作った、あるいは大きく変更したときは、CFAなどによる追加の検証を検討します。CFAでは、どの項目がどの因子を測るかを、事前にモデルとして指定します。既存の測定モデルがはっきりしているなら、EFAを経ずに、CFAから始める選択もあります。したがって、「EFAのあとに、必ずCFAを行う」という固定した順序ではありません。
標本数に余裕があるなら、探索用と検証用に標本を分け、探索用でEFA、検証用でCFAを行うのが、より望ましい方法です。ただし、CFAを行ったからといって、そのあと必ずCFAの因子得点を使わなければならないわけではありません。
手順7: 下位尺度を、回帰分析とQCAに使う
回帰分析
下位尺度ができたら、通常の回帰分析ができます。
\[
Y = \beta_0 + \beta_1 \text{Trust} + \beta_2 \text{Quality} + \beta_3 \text{Price} + \varepsilon
\]
summary (lm (Y ~ Trust + Quality + Price, data = dat))
Call:
lm(formula = Y ~ Trust + Quality + Price, data = dat)

Residuals:
     Min       1Q   Median       3Q      Max
-3.11817 -0.87767  0.06223  0.76259  2.85718

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  1.42862    0.37338   3.826 0.000159 ***
Trust        0.57160    0.06622   8.632 3.78e-16 ***
Quality      0.36507    0.05991   6.093 3.44e-09 ***
Price       -0.27133    0.05812  -4.668 4.61e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.157 on 296 degrees of freedom
Multiple R-squared:  0.4399,    Adjusted R-squared:  0.4342
F-statistic: 77.49 on 3 and 296 DF,  p-value: < 2.2e-16
QCA
QCAでは、ケースごとに条件の値が必要です。この例なら、ブランド信頼、知覚品質、価格感度の下位尺度を、条件として使えます。ファジィセットQCA(fsQCA)では、それぞれを、集合のメンバーシップ(0から1の値)へキャリブレーション します。結果の購買意向 Y も、「購買意向が高い」という集合へ、キャリブレーションします。
そのうえで、たとえば「ブランド信頼が高く、知覚品質が高く、価格感度が低い」という組み合わせについて、次のような十分条件の関係を検討します(~ は否定、* は論理積です)。
\[
\mathrm{TRUST} * \mathrm{QUALITY} * {\sim}\mathrm{PRICE} \rightarrow \mathrm{PURCHASE}
\]
注意点は、次のとおりです。
この式は、分析の結果ではありません。検討する組み合わせの例 です。
キャリブレーションの基準(完全に含まれる、完全に含まれない、どちらでもない点)は、尺度の平均を、機械的に0から1へ変換するのではなく、集合の意味に基づいて決めます。
例題の Y は、購買「意向」を測ったものです。実際の購買「行動」とは、区別して書いてください。
キャリブレーションと分析の実際は、ThSQCA 入門のシリーズ を見てください。
回帰分析とQCAを併用する意味
同じ下位尺度で回帰分析とQCAを行うと、同じ現象を、別の観点から見られます。回帰分析では、他の変数を一定としたときの平均的な関連 を見ます。QCAでは、どの条件の組み合わせが結果につながるか を見ます。両者は、競合する方法というより、異なる観点を持つ、補完的な方法として位置づけられます。共通の下位尺度を使えば、測定を、2つの分析で統一できます。
報告に書くこと
論文や報告書には、少なくとも次を書いておくと、読者が手順をたどれます。
構成概念の定義と、項目の出典(既存尺度か、自作か)
標本数と、欠損値の扱い(完全なケースだけを使った、など)
因子分析の推定法(主因子法など)、回転(プロマックス)、因子数の根拠
逆転項目
下位尺度ごとの項目数と、α
下位尺度の作り方(項目の単純平均)
この手順を、一言でまとめると
実務的な標準手順は、次の11段階です。この記事の手順1〜7は、このうち、CFA(8)とSEM(11)を除く部分を、尺度づくりの順に並べ直したものです(逆転項目の確認を加えています)。
先行研究から、構成概念を定義する
各構成概念について、複数の質問項目を準備する
「どの項目が、どの構成概念を測るか」という理論的想定を、事前に持つ
EFAで、その想定と実際のデータ構造との整合性を、探索的に検討する
理論と統計の両面から、項目を検討する
内的一貫性として、Cronbachのα(必要ならMcDonaldのω)を確認する
単純平均で、下位尺度を作る
必要に応じて、CFAで測定構造を追加検証する
下位尺度を、回帰分析などに使う
QCAでは、下位尺度をキャリブレーションして使う
潜在変数間の構造そのものが研究目的なら、SEMを検討する
最も大切なのは、「データを取ってから、因子分析で意味を探す」のではなく、「理論的に意味を定義し、その意味がデータ上でも整合しているかを、因子分析で探索的に検討する」ことです。
\[
\text{理論} \rightarrow \text{構成概念} \rightarrow \text{測定項目} \rightarrow \text{測定構造の検討} \rightarrow \text{尺度化} \rightarrow \text{回帰・QCAなどによる仮説検証}
\]
構成概念を使うからSEMを使う、という機械的な判断をする必要はありません。重要なのは、研究質問、理論、測定方法、尺度の作り方、分析方法が一貫していること です。
なお、SEMを使わない理由や、SEMとの比べ方は、この記事では扱いません。別の記事(Notes)で書く予定です。
次に読むもの
この記事で作った下位尺度は、QCAにも使えます。回帰分析が、他の変数を一定としたときの平均的な関連を見るのに対し、QCAは、どの条件の組み合わせが結果につながるか を探します。ThSQCA は、結果の目標水準(閾値)を動かしたときに、その組み合わせがどう変わるかを調べるRパッケージです。
このページのRの環境
結果は、次の環境で確かめたものです。固定したシードで同じデータが作られますが、Rやパッケージのバージョンが違うと、結果が少し変わることがあります。
[1] "R version 4.6.1 (2026-06-24 ucrt)"